
Материалы по тегу: open source
|
22.10.2026 [00:19], Павел Котов
DeepSeek открыла исходный код DeepInfer — фреймворка для инференса своего ИИКитайская ИИ-лаборатория DeepSeek открыла исходный код DeepInfer — фреймворка для инференса, на базе которого работают собственные сервисы компании, сообщает SiliconANGLE. Ключевой задачей продукта разработчик называет обеспечение работы с большой пользовательской базой при сохранении приемлемой стоимости. Один кластер, по заявлению DeepSeek, обрабатывает 155 трлн токенов в сутки, а доход при использовании тарифов в периоды низкой нагрузки составляет $38/час на один GPU. На данный момент DeepInfer поддерживает только модель DeepSeek-V4.1-Flash — по умолчанию загружается версия 1017, вышедшая в минувшие выходные. Фреймворк совместим с NVIDIA Blackwell (SM100) и Huawei Ascend 950; поддержка архитектуры NVIDIA Hopper и более старых поколений не предусмотрена. В DeepInfer есть две функции, гарантирующие получение идентичных результатов при повторном запуске с одинаковыми исходными данными. Они работают только на ускорителях NVIDIA. Быстродействие DeepInfer DeepSeek проверяла только на ускорителях NVIDIA, поэтому приведённые результаты бенчмарков получены исключительно в ходе собственных испытаний компании. 
Источник изображения: DeepSeek В DeepInfer предусмотрены два способа ускорения работы модели. Спекулятивное декодирование с помощью системы DSpark предполагает генерацию сразу пяти токенов вспомогательной моделью; модуль оценки прогнозирует, какие из них будут приняты основной моделью. Вычислительные ресурсы для проверки затрачиваются только на наиболее вероятные варианты, благодаря чему количество проверяемых «черновых» токенов на каждом шаге сокращается на 30 %. В реальных рабочих нагрузках это обеспечивает прирост производительности на 4–7 %. Второй механизм почти вдвое сокращает объём вычислений при первичной обработке запроса: через слои декодера модели повторно пропускаются только последние 128 токенов, а не весь запрос целиком. Код для управления KV-кешем и балансировки нагрузки DeepSeek пока не опубликовала, пояснив, что эти компоненты тесно связаны с внутренней инфраструктурой. DeepInfer преимущественно ориентирован на разделение нагрузки между первичной обработкой запросов и генерацией ответов, но реализовывать этот механизм пользователям придётся самостоятельно. В качестве минимальной эффективной конфигурации указываются 128 GPU: по 64 для первичной обработки и генерации ответов. Фреймворк DeepInfer доступен на GitHub под лицензией Apache 2.0. В комплект входит библиотека deepseek-recipe, которая преобразует запросы в последовательности токенов, используя ту же логику, что и официальный API DeepSeek. В этом же репозитории будет размещаться код для инференса будущих моделей. Поддержка платформы Ascend в DeepInfer появилась вслед за релизом от 30 сентября, в рамках которого DeepSeek при содействии Huawei обеспечила поддержку TileLang — китайского аналога NVIDIA CUDA. Во Внутренней Монголии ИИ-лаборатория намерена построить кампус ИИ ЦОД мощностью 1 ГВт и развернуть там не менее 160 тыс. ускорителей Huawei Ascend 950DT. Ранее стало известно, что DeepSeek занимается разработкой и собственного ИИ-ускорителя для инференса, чтобы снизить свою зависимость как от NVIDIA, так и от Huawei.
21.10.2026 [15:03], Павел Котов
Google представила TorchTPU — средство для работы с PyTorch на TPUGoogle представила программный комплекс TorchTPU с открытым исходным кодом, предназначенный для запуска ИИ-моделей с использованием фреймворка PyTorch на ускорителях TPU. Проект призван упростить использование ускорителей Google в обучении и инференсе ИИ; поддерживаются популярные программные средства — создавать отдельную программную среду для TPU не требуется. Разработанный совместно с командой PyTorch в Meta✴ инструментарий TorchTPU позволяет запускать существующие проекты в PyTorch с минимальными изменениями кода, используя привычный API. Поддерживаются отладка в обычном режиме PyTorch и механизмы распределенных вычислений. Google заручилась поддержкой Hugging Face, благодаря чему представленные на ИИ-платформе открытые модели могут запускаться нативно через TorchTPU — поддерживаются библиотеки Transformers v5 и Diffusers. Программный модуль vLLM для TorchTPU поддерживает одновременную обработку множества запросов, квантизацию и распределение вычислений между чипами TPU; стандартные средства управления вычислениями и обработки запросов сохранены. Для TPU адаптирован инструмент SGLang — он позволяет ускорять сложные многоэтапные задачи, в том числе выполняемые ИИ-агентами; поддерживаются повторные обращения к KV-кешу и повторяющиеся префиксы запросов. Версия SGLang-TorchTPU сохранила механизмы выполнения задач, распределения запросов и API. Средства обмена данными с HiCache помогают сократить задержку и оптимизировать вывод при сложной многоэтапной генерации. 
Источник изображения: youtube.com/@googlecloudtech Совместно с Red Hat, IBM и сообществом разработчиков выпущен роутер llm-d 1.0 — он направляет запросы к экземплярам модели, где уже сохранен контекст, а также разделяет обработку входного запроса и генерацию ответа по вычислительным ресурсам, что позволяет использовать их эффективнее. В Google Kubernetes Engine этот инструмент поддерживает запуск моделей как на GPU, так и на TPU. Google интегрировала TorchTPU с TorchTitan — инструментом распределённого обучения крупных моделей; поддерживаются, в частности, Llama 3, Qwen 3 и FLUX.1. Поддержка появилась в VeRL — одном из наиболее популярных фреймворков для обучения с подкреплением. Заявлено о поддержке TorchTPU в Ray — этот инструмент для распределения вычислительных задач позволяет объединить обработку данных, обучение, и инференс в рабочий процесс с использованием CPU, GPU и TPU. В экосистему PyTorch вошла библиотека LiteRT, предназначенная для запуска моделей на пользовательских устройствах. Google также представила предварительную версию TPU agent suite — при помощи плагинов этот набор инструментов помогает автоматизировать первоначальную настройку, диагностику и оптимизацию моделей в PyTorch. Поддержку PyTorch на своих ускорителях реализовали также Amazon, Intel и Meta✴.
20.10.2026 [18:47], Павел Котов
Amazon представила TorchNeuron — средство запуска PyTorch на чипах AWS TrainiumAmazon анонсировала TorchNeuron — инструментарий с открытым исходным кодом, позволяющий запускать рабочие нагрузки PyTorch на ИИ-ускорителях AWS Trainium. До настоящего момента запуск на чипах Trainium самого популярного в отрасли фреймворка PyTorch для разработки ИИ-систем требовал значительного объёма ручной работы — затраты на разработку увеличивались, создавался барьер для пользователей. TorchNeuron позволяет запускать проекты PyTorch на чипах Trainium, не внося масштабных изменений в код. Разработчикам, подчеркнули в Amazon, достаточно лишь задать параметр, какой именно чип следует использовать для выполнения задач. Поддерживаются Trainium2 и Trainium3 — две новейшие модели в линейке этих ускорителей; они подходят как для обучения, так и для инференса моделей. 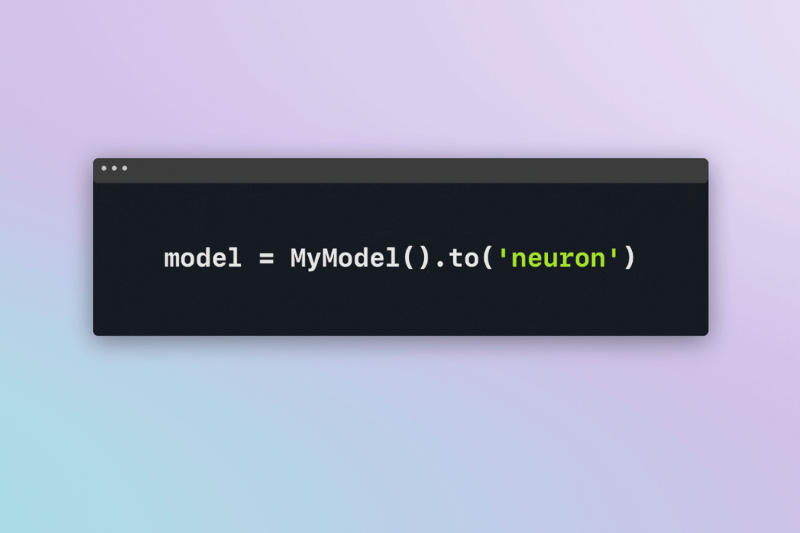
Источник изображения: aboutamazon.com Для серии Trainium был разработан собственный язык программирования NKI; благодаря наличию специального компилятора этот язык позволяет производить низкоуровневую оптимизацию моделей, благодаря чему снижается потребление аппаратных ресурсов и повышается скорость работы ИИ. В состав TorchNeuron входит набор готовых операторов NKI — программных компонентов, которые можно использовать при создании ИИ-моделей. Одни из них упрощают реализацию MoE-архитектуры, другие помогают сократить объём используемой памяти. Ускоряется выполнение и сопутствующих задач, например, квантования. TorchNeuron поддерживает не только PyTorch, но и другие открытые инструменты, которые разработчики часто используют в связке с этим фреймворком. Среди них есть TorchTitan — популярный механизм для обучения ИИ-моделей. Он автоматизирует часть задач, связанных с распределением процессов между ускорителями; метод полностью сегментированного параллелизма данных разделяет не только обучаемую модель, но также состояния оптимизатора и градиенты. В состав TorchNeuron вошли функции, позволяющие дополнительно оптимизировать рабочий процесс обучения с использованием ускорителей Trainium.
15.10.2026 [15:08], Павел Котов
Jefferies: китайский ИИ грозит устроить «перезагрузку» отрасли с триллионными оборотамиАналитики Jefferies задались вопросом, приведёт ли падение затрат на искусственный интеллект из-за появления дешёвых открытых китайских моделей к «перезагрузке» всей отрасли ИИ, в то время как поставщики облачных услуг стремятся окупить триллионные капитальные затраты, пишет The Register. Около половины из резервов по контрактам Microsoft, Alphabet, Amazon и Oracle в общей сложности на $2,3 трлн связаны с OpenAI и Anthropic, говорится в недавней исследовательской заметке Jefferies, посвящённой азиатским рынкам. При этом китайские модели ИИ, открытые модели и малые языковые модели грозят обрушением ценовой политики, которую устанавливают два лидера отрасли из США, что ставит под сомнение их будущие доходы. На агрегаторе OpenRouter за неделю, завершившуюся 27 сентября, китайские модели обработали 76,12 трлн токенов — в конце апреля этот показатель составлял 4,37 трлн. На модели четырёх крупнейших американских разработчиков пришлись 14,2 трлн токенов. В авангарде китайская Moonshot AI Kimi K3, которая состязается напрямую с Anthropic Claude Fable 5. В этом году крупнейшие гиперскейлеры в общей сложности потратят от $600 млрд до $800 млрд на строительство ИИ ЦОД, финансируя эти проекты всё больше за счёт долговых обязательств, а не собственных средств. И в Jefferies пытаются понять, откуда будут поступать будущие доходы этих компаний: «Больше нельзя исходить из того, особенно с появлением таких систем как Kimi K3, что LLM когда-либо будут прибыльными, учитывая связанный с этим обвал цен на токены. Для гиперскейлеров это чрезвычайно актуально, потому что они вложились в мощности ЦОД, рассчитывая, что их закупят такие компании как Anthropic и OpenAI». 
Источник изображения: BoliviaInteligente / unsplash.com В долгосрочной перспективе ставка на ИИ может представляться целесообразной, но в среднесрочной неопределённость очень велика. «В какой-то момент не столь отдалённого будущего история ИИ должна подвергнуться большой перезагрузке. Действительно ли капзатраты четырёх гиперскейлеров в 2027 году составят $993 млрд?» — задают вопрос аналитики. Важным оказывается и вопрос о том, какая часть заявленной прибыли гиперскейлеров зависит от их инвестиций в разработчиков моделей ИИ, от которых будут также зависеть доходы. Особую важность в отчётности приобретает статья «Прочие доходы и расходы», в которую входит прибыль от вложений. И эти вложения, указывают в Jefferies, «вероятно, будут включать позиции в неторгуемых акциях, связанных с ИИ». За четыре квартала до II квартала 2026 года приведённая годовая прибыль четырёх крупнейших гиперскейлеров выросла на $222 млрд и достигла $581 млрд, но весь этот рост объясняется статьёй «Прочие внеоперационные доходы/расходы» — показатели по ней выросли на $224 млрд г/г, достигнув $237 млрд, то есть именно на них пришёлся «весь рост прибыли». Другое исследование показало, какой объём доходов и займов может потребоваться облачным провайдерам для финансирования планов по строительству ЦОД: к 2031 году отрасль ИИ должна генерировать $6 трлн в год, чтобы продолжать финансировать инфраструктуру, необходимую для удовлетворения ожидаемого спроса. То есть отрасли потребуются новые сценарии применения, помимо повышения производительности труда сотрудников. Уже в следующем году капзатраты гиперскейлеров превысят $1,5 трлн, подсчитали в TrendForce. Google, Meta✴ и Microsoft поддержали обязательство по полной оплате расходов на энергетическую инфраструктуру для ЦОД. В Банке Англии, однако, уверены, что скорой экономической выгоды от ИИ ждать не следует.
30.09.2026 [01:05], Владимир Мироненко
Платформа NVIDIA Open Agent Safety Platform обеспечит безопасное использование ИИ-агентов — от тестирования до развёртыванияNVIDIA представила открытую платформу обеспечения безопасности агентов Open Agent Safety Platform для реализации более безопасных рамок работы ИИ-агентов на всех этапах: от тестирования до развёртывания. NVIDIA Open Agent Safety Platform включает в себя open source ПО NVIDIA OpenShell и эталонную архитектуру системы NVIDIA Sentry. Платформа обеспечивает комплексное управление и контроль на всех уровнях стека: от ПО до аппаратных, вычислительных и роботизированных систем, на которых функционируют агенты. ПО OpenShell создает защищённую среду выполнения, которая отслеживает все действия агентов и обеспечивает соблюдение заданных правил безопасности во время их работы. Защищённый контур выполнения позволяет контролировать, как автономные ИИ-агенты решают задачи с использованием как открытых, так и закрытых моделей. Компания отметила, что OpenShell обеспечивает защиту с минимальными накладными расходами при работе на NVIDIA Vera. Сочетание OpenShell и Vera позволяет агентам безопасно функционировать и выполнять задачи с максимальной скоростью. Поскольку OpenShell — решение open source, его можно адаптировать для работы с вычислительными платформами сторонних производителей, включая Arm и Intel. 
Источник изображения: NVIDIA Система Sentry дополняет OpenShell независимым модулем мониторинга (watchdog), работающим на базе DPU NVIDIA BlueField-4 и непрерывно отслеживающим поведение агента. Sentry обеспечивает принудительное соблюдение мер безопасности на аппаратном уровне и способна за считанные миллисекунды изолировать (поместить в карантин) агентов, если те предпринимают попытки выйти за пределы установленных границ. Sentry объединяет функции обнаружения угроз, аппаратного управления агентами и защиты доступа к данным, действуя в изолированной доверенной среде, отделённой от основного вычислительного потока; она реагирует в режиме реального времени и остается невидимой как для самих агентов, так и для злоумышленников. Система Sentry построена на базе ПО NVIDIA DOCA, которое предоставляет возможности программирования, используемые Sentry для анализа запросов и ответов агентов, сбора телеметрии, проверки подлинности агентов и обеспечения соблюдения детализированных политик доступа по модели Zero Trust к данным, инструментам, API и сервисам. С целью повышения безопасности использования ИИ NVIDIA объединила усилия с ведущими компаниями ИИ-экосистемы, охватывая весь стек технологий — от инфраструктуры и ПО до моделей и робототехники. В их числе Anthropic, Cisco, CrowdStrike, Dell, Figure, HPE, Hugging Face, JPMorganChase, Microsoft, Palantir, Palo Alto Networks, Perplexity, Red Hat, Salesforce, SAP, Scale AI, ServiceNow и SpaceXAI. В частности, NVIDIA объединила усилия с Anthropic для внедрения дополнительных уровней безопасности и контроля в архитектуру агентных систем. Решение Claude Managed Agents формирует защитный контур, разделяя процессы управления агентами (цикл выполнения агента) и среды их непосредственной работы (песочницы). Интеграция с OpenShell и BlueField обеспечивает корпоративным клиентам контроль доступа агентов к ресурсам внутри этих песочниц. SpaceXAI использует платформу NVIDIA Open Agent Safety Platform для работы с агентами для написания кода Cursor и моделями Grok. А Scale AI использует эталонную архитектуру NVIDIA Open Agent Safety Platform для создания надёжных агентных ИИ-систем, предназначенных для корпоративных и государственных заказчиков, внедряя её в уровень агентной инфраструктуры портфеля решений Scale GenAI. Salesforce и NVIDIA интегрировали OpenShell с платформой Slack, что позволяет командам управлять активностью агентов OpenShell непосредственно в Slack: отслеживать действия агентов и события аудита, а также одобрять или отклонять запросы агентов на расширение прав доступа. Red Hat использует компоненты платформы (OpenShell и DOCA) в решении Red Hat AI Factory with NVIDIA. Среди более чем 100 организаций, использующих технологии платформы NVIDIA Open Agent Safety Platform, — Accenture, Armadin, Cadence, Cognition, CrowdStrike, Cisco, Dassault Systèmes, Deloitte, EY, Hugging Face, IBM, Irregular, Perplexity, Microsoft, SAP, Scale AI, ServiceNow, Siemens, Synopsys, OpenClaw, Palantir и Palo Alto Networks.
15.09.2026 [17:03], Руслан Авдеев
Юристы Latham & Watkins закупились NVIDIA-серверами — это плохой знак для Anthropic и OpenAIАмериканская юридическая компания Latham & Watkins закупила серверы на основе ИИ-ускорителей NVIDIA и занялась самостоятельной кастомизацией ИИ-моделей с открытыми весами. Это первый известный пример использование собственной ИИ-инфраструктуры и настройки ИИ-моделей крупным юридическим бизнесом, сообщает The Financial Times. Компания является второй по величине юридической фирмой в США с выручкой $8,3 млрд в 2025 году. Других примеров использования юридическими бизнесами собственной инфраструктуры и дообучения моделей пока неизвестно. С одной стороны, компания теперь отвечает за киберзащиту и эксплуатацию серверов, с другой — конфиденциальные данные клиентов она может хранить, не полагаясь на сторонние облака. Юридический бизнес связан с большими объёмами информации, а также стандартными и повторяющимися задачами — это один из секторов, которые ИИ меняет наиболее быстро. Крупные американские банки требуют от больших юридических фирм снижать стоимость услуг, поскольку ИИ значительно ускоряет выполнение многих задач. Тем не менее у юристов есть веские причины не инвестировать в ИИ слишком большие средства, поскольку большие капитальные затраты в итоге сокращают прибыль, распределяемую между партнёрами-совладельцами. Обычно такие компании прибегают к помощи облачных ИИ-сервисов. 
Источник изображения: Erik Mclean/unsplash.com Решение Latham & Watkins купить собственное оборудование знаменует собой радикальные изменения подхода к ведению дел. Штатные разработчики адаптируют открытые модели для решения специальных юридических задач. Чаще такая практика встречалась в технологической сфере. Прочие юридические компании обычно выбирают другую стратегию. Так, более крупный конкурент — Kirkland & Ellis работает над разработкой собственных ИИ-инструментов с Palantir, а A&O Shearman взаимодействует со стартапом Harvey, специализирующимся на юридических технологиях. Наконец, Freshfields в текущем году объявила о работе с Anthropic. Компания наняла более 900 технологических специалистов, включая инженеров по машинному обучению, ИИ-разработчиков, занимающихся программированием юристов и др. Latham & Watkins пока не отказывается от использования сторонних ИИ-продуктов, но не сообщает, сколько именно она тратит на собственные разработки, над которыми, как оказалось, трудится уже несколько лет. Затраты на покупку ИИ-оборудования в таких масштабах, оплата работы специалистов, обслуживание и защита системы может обходиться в десятки миллионов долларов ежегодно, потенциально — сотни миллионов по мере развития технологий. Latham & Watkins арендует пространство в ЦОД, куда есть доступ только сотрудникам самой компании. Команда специалистов занимается дообучением моделей NVIDIA Nemotron 3. Такой подход позволяет юристам использовать широкий круг моделей, а не только ChatGPT, Claude или Gemini. В зависимости от задач, компания может выбирать использование своих ИИ-инструментов или коммерчески доступных продуктов. Кроме того, компания получает дополнительную защиту на случай, если ИИ-бизнесы вроде OpenAI или Anthropic поднимут цены или изменят условия обслуживания. Открытые модели позволяют кастомизировать их на собственное усмотрение и запускать их на своём оборудовании. В самой NVIDIA рассчитывают, что открытые модели помогут привлечь к использованию ИИ больше клиентов.
25.08.2026 [17:52], Руслан Авдеев
«Зомби-иск» о коде Linux вот-вот окончательно закопаютМноголетняя судебная тяжба, касающаяся прав собственности на Linux, которому сегодня исполнилось 35 лет, ближе к завершению чем когда-либо. Три судьи апелляционного суда в США вынесли решение о том, что иск в отношении IBM и Red Hat не имеет оснований, а срок для дальнейших юридических манёвров истёк, сообщает The Register. История началась ещё в 1998 году, когда в IBM пришли к выводу, что миру достаточно одной версии ОС UNIX, способной работать на разных архитектурах процессоров. Для этого компания совместно с Santa Cruz Operation (SCO), выпускавшей версию UNIX на архитектуре x86, Intel и Sequent заключили соглашение о реализации т.н. Project Monterey, который конкурировать с Linux не смог. Поэтому IBM решила перенести в Linux часть кода, созданного в процессе реализации Project Monterey, после чего SCO и её юридические преемники заявили, что код Linux в некоторой степени принадлежит им, как и, отчасти, права на операционную систему. В 2021 году TSG Group, представлявшая интересы части некогда причастных к SCO структур и лиц, заключила с IBM мировое соглашение на $14,25 млн. Такая сумма свидетельствует, скорее, об отсутствии сильных доказательств SCO, чем об успехе инициаторов тяжб. Ещё одна преемница — Xinuos подала новый иск, требуя привлечь IBM к ответственности, поскольку та якобы использовала не принадлежащий ей код для Linux, и знала об этом — у IBM была лишь неэксклюзивная лицензия на его использование. Xinuos утверждала, что передав код Project Monterey в Linux, IBM нарушила условия лицензирования. 
Источник изображения: ZBRA Marketing/unsplash.com Xinuos представила соответствующие аргументы в окружном суде США по Южному округу Нью-Йорка, но так и не сумела убедить судей в том, что IBM и Red Hat вообще должны нести перед ней ответственность. Первоначально иск отклонили ещё в 2025 году, поскольку Xinuos ещё тогда не смогла доказать, что имеет право быть истцом в этом деле. После подачи апелляции Апелляционный суд США второго округа решил, что решение окружного суда не подлежит пересмотру. Суд посчитал, что представленные документы не позволяют вновь рассматривать вопрос по исходному решению, касающемуся Project Monterey — слишком поздно. Кроме того, истец пытался представить дело, как спор о лицензировании, тогда как фактически речь шла об установлении права собственности, которого у Xinuos, вероятно, нет вообще. Xinuos не намерена сдаваться — компания намерена ходатайствовать о рассмотрении дела полным составом Апелляционного суда. Вероятно, этого никогда не случится, поскольку такое происходит крайне редко и если суд обнаружит существенные ошибки или важные юридические упущения, которые оправдывали бы повторное рассмотрение дел. Данный окружной апелляционный суд соглашался на пересмотры дел в 0,03 % случаев. Другими словами, возвращение «зомби-иска» к жизни крайне маловероятно.
20.08.2026 [18:11], Руслан Авдеев
«Спасибо, Oracle!»: создатель Postgres поблагодарил IT-гиганта за закат MySQLПо словам создателя Postgres Майкла Стоунбрейкера (Michael Stonebraker), Oracle невольно помогла мировому распространению СУБД PostgreSQL, теперь поддерживаемую Microsoft, AWS и Google, сообщает The Register. Покупка Sun Microsystems вместе с MySQL и последующий неэффективный менеджмент привёл к тому, что PostgreSQL стала доминировать во всём мире. PostgreSQL была представлена 30 лет назад, после добавления поддержки SQL системе Postgres, разработанной Стоунбрейкером десятью годами ранее. В итоге СУБД десятилетиями неспешно набирала популярность, но стремительный рост востребованности пришёлся лишь на последние пять лет. По данным Stack Overflow, в 2023 году она стала наиболее популярным вариантом СУБД среди разработчиков. Впрочем, речь идёт не только о собственно PostgreSQL — вендоры, включая облачных гиперскейлеров, CockroachDB, YugabyteDB, Postgres Pro, Tantor Labs и др. предлагают решения, обеспечивающие различную степень совместимости с «исходным» продуктом. По словам Стоунбрейкера, PostgreSQL фактически находится в процессе «завоевания мира», подразумевая под этим весь спектр совместимых на уровне формата хранения СУБД, а MySQL «исчезает как конкурент». При этом у последней есть наследница в лице MariaDB. Oracle получила MySQL в 2010 году в рамках покупки Sun, которая приобрела MySQL AB за два года до этого. В своё время MySQL была крайне благосклонно принята множеством крупных компаний и разработчиков. Тем не менее, в последние пару лет бизнес поставил под вопрос готовность Oracle вкладываться в развитие этой СУБД. Стоунбрейкер не без иронии подчеркнул, что популярности PostgreSQL обязана именно действиям Oracle. 
Источник изображения: Max Duzij/unsplash.com Осенью 2025 года Oracle организовала масштабные сокращения в своей ключевой команде разработки MySQL. Летом 2026 года обеспокоенное сообщество пользователей и разработчиков основало фонд OurSQL Foundation. Он призван помочь выступить единым фронтом против Oracle, владеющей интеллектуальной собственностью, связанной с MySQL. В ответ Oracle объявила о новом этапе в управлении MySQL, который позволит членам сообщества вносить свой вклад в развитие экосистемы с участием в улучшении кода, тестировании, закрытии уязвимостей, ведении документации, обзоров и технических дискуссий. Стоунбрейкер подчёркивает, что PostgreSQL не контролируется единым вендором, а управляется группой из 20–30 «очень умных суперпрограммистов». Стоунбрейкер надеется, что проект навсегда останется неподконтрольным какому-либо одному вендору, назвав его «open source в его лучшем проявлении». С момента создания Postgres сам Стоунбрейкер создал ряд компаний, связанных с СУБД, включая Illustra и Vertica. Три года назад пенсионер стал сооснователем компании DBOS, которая специализируется на агентных ИИ. Утверждается, что DBOS обеспечивает приложениям автоматическое восстановление после сбоев с сохранением состояния рабочего процесса и истории его выполнения. Технологии компании используют Databricks и CockroachDB, а последняя обеспечивает совместимость с PostgreSQL и использует технологии DBOS при развёртывании ИИ-агентов.
17.08.2026 [17:47], Руслан Авдеев
Концепция европейского ИИ-суверенитета Mistral AI включает создание 1 ГВт мощностей и… китайские LLMФранцузская Mistral AI продолжает развивать концепцию обеспечения европейского ИИ-суверенитета. Компания намерена дать клиентам больше контроля за географией размещения ИИ-проектов и намерена заключить долгосрочные договорённости, которые позволяет её создать в Европе до 1 ГВт вычислительных мощностей к 2030 году, сообщает eWeek. Т.н. Mistral Regional Endpoints теперь доступны широкому кругу клиентов. Фактически речь идёт о программной функции, позволяющей выбирать, где именно будет выполняться инференс — в США или Европе. В результате пользователи смогут контролировать, где именно будут храниться и обрабатываться данные, будет обеспечено соблюдение необходимых правовых норм и выполнение требований к задержке передачи данных. Дополнительно компания представила для предварительной оценки тариф Priority Tier для критически важных рабочих нагрузок с SLA. Он в 1,75 раза дороже стандартного тарифа, гарантированный уровень доступности сервисов — 99,5 %. Впрочем, предложение региональной обработки данных не значит, что все элементы ИИ-приложений будут привязаны к выбранной локации. Mistral подчёркивает, что не исключена ограниченная и защищённая передача данных «субпроцессорам» за пределами заданного региона. Это может иметь значение для работающих в регулируемых отраслях структур (госсектор, здравоохранение, оборонная промышленность и др.). Особенно это значимо в регионе EMEA, где организации нередко взвешивают преимущества внедрения ИИ, учитывая риски для суверенитета данных. В своё время Microsoft уже признала, что не сможет обеспечить настоящий суверенитет, если информация потребуется американским властям. 
Источник изображения: Sylwia Bartyzel/unsplash.com Также Mistral открывает свою платформу для моделей компаний-конкурентов. Например, её инфраструктура будет поддерживать сторонние LLM, включая GLM-5.2 китайской компании Z.AI. Благодаря этому клиенты получат доступ к разным ИИ-инструментам без необходимости переноса рабочих нагрузок между инфраструктурными провайдерами. В Mistral подчёркивают, что открытые веса моделей позволяют подробно изучать их устройство, адаптировать к своим потребностям и сохранять результаты, созданные с их использованием. Ещё важнее инициатива Mistral, предусматривающая объединение европейских компаний для обеспечения долгосрочного доступа к вычислительным ИИ-мощностям. Т.н. European Compute Units, предлагаемые компанией, позволяют преобразовать долгосрочные обязательства клиентов в помощь в создании инфраструктуры Mistral и доступу к ней. К 2030 году компания намерена добиться совокупной мощности до 1 ГВт. По имеющимся данным, сегодня Mistral располагает менее 200 МВт вычислительных мощностей, этого показателя она намерена добиться к концу 2027 года. Открытые модели, обработка данных в разных регионах и долгосрочные договорённости позволяют Mistral позиционировать себя как европейскую альтернативу зарубежным поставщикам ИИ- и облачных сервисов, преимущественно американским. В марте сообщалось, что Mistral AI привлекла в долг $830 млн для оснащения ИИ ЦОД и конкуренции с американскими техногигантами.
31.07.2026 [13:02], Андрей Крупин
Исследование: российский бизнес переходит к гибридным СУБД-ландшафтамОтечественные системы управления базами данных доминируют в корпоративной IT-инфраструктуре, однако параллельно активно используются решения с открытым исходным кодом и зарубежные платформы. Об этом свидетельствуют результаты исследования компании Nexign — российского разработчика enterprise-решений для различных отраслей экономики. По данным опроса Nexign, СУБД от отечественных вендоров доминируют в инфраструктуре российских компаний — об их использовании сообщили 66 % респондентов. Более половины — 54 % — опрошенных применяют решения open source, 40 % продолжают эксплуатировать зарубежные продукты, ещё 6 % затруднились с ответом. По мнению аналитиков, такие результаты отражают переходный характер текущего этапа развития IT-ландшафта в России. Существенная доля зарубежных решений объясняется значительным объёмом устаревшей инфраструктуры в слое прикладных корпоративных систем. Многие бизнес-критичные приложения исторически разрабатывались и внедрялись в тесной связке с конкретными СУБД. Пока прикладной слой не модернизирован или не заменён, полная миграция баз данных зачастую оказывается либо технически сложной, либо экономически неоправданной. 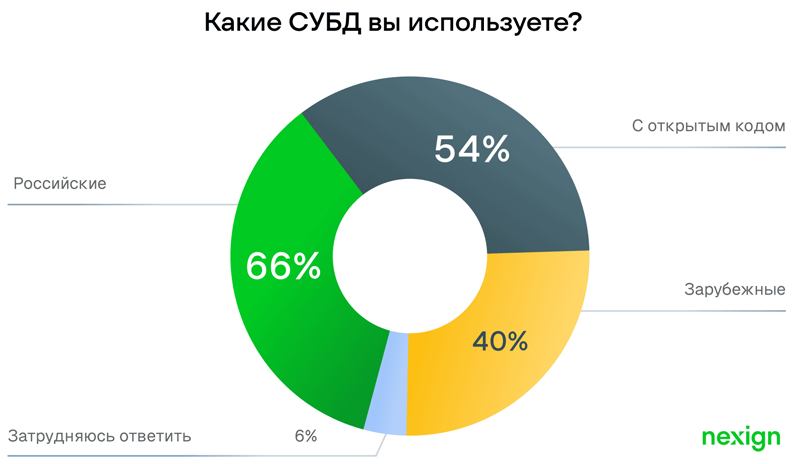
Источник изображения: Nexign / nexign.com По данным исследования, компании в среднем используют более одного типа СУБД, комбинируя вендорские продукты и open source. Такой подход продиктован несколькими важными факторами. Во-первых, бизнес стремится снизить риски зависимости от вендора. Во-вторых, значительная часть существующих систем не может быть быстро выведена из эксплуатации без ущерба для бизнес-процессов. В-третьих, использование различных СУБД позволяет организациям балансировать между стоимостью владения, доступностью квалифицированной поддержки и надёжностью решения. Также наличие открытого кода даёт необходимую гибкость и свободу в настройке, в то время как вендорские решения обеспечивают формальные гарантии и SLA. Однако гибридный подход несёт и определённые риски, отмечают эксперты Nexign. Главный из них — возрастающая сложность администрирования и поддержки разнородной инфраструктуры. Кроме того, усложняются процессы мониторинга и обеспечения безопасности: при неграмотном использовании открытого кода в системе могут образовываться серьёзные уязвимости. Существует также риск непредсказуемого роста совокупной стоимости владения (TCO) при недостаточно продуманной архитектуре. Что касается критериев, на которые заказчики обращают внимание при выборе СУБД, то для 68 % опрошенных организаций ключевыми требованиями являются отказоустойчивость, поддержка кластеризации и возможность быстрого восстановления после сбоев. Для 66 % важны поддержка высокой нагрузки и масштабируемость, включая горизонтальное масштабирование и репликацию. Соответствие требованиям ФСТЭК и Роскомнадзора, а также наличие сертификации по защите данных, указывают своим приоритетом 38 % опрошенных. Это говорит о том, что для заказчиков становятся важны не только функциональность СУБД, но и технические характеристики, которым ранее уделялось меньше внимания. Компаниям сейчас не нужен «комбайн» со множеством новых функций. Прежде всего они ждут, что СУБД легко впишется в IT-среду и обеспечит безболезненный перенос данных. |
|

